제미나이 4 아르곤, 진짜 좋냐?
사람들이 지금 가장 궁금해하는 건 단순한 출시 소식보다도 “Gemini 4 Argon이 진짜 좋냐, 그래서 지금 써볼 만하냐”는 질문입니다. Google이 2026년 10월 13일 Gemini 4 Argon의 글로벌 제공을 발표한 뒤, 관심은 자연스럽게 Claude Fable·Opus, GPT-6 계열과 비교했을 때 무엇이 낫고 무엇이 아직 애매한지로 모였습니다. Google 공식 출시 안내
이 글은 기준일 2026년 10월 15일 기준으로 출시 정보·실사용 반응·코딩 평가·API 가격을 다시 정리한 것입니다. 결론부터 말하면, Argon은 가격 메리트·1M 컨텍스트·일부 코딩에서 확실히 눈길을 끌지만, 압도적 체감·안정감·생태계는 더 지켜봐야 한다는 반응도 함께 나옵니다. Claude와 OpenAI 모델은 이름이 비슷한 제품·작업 도구가 함께 언급되므로, 모델과 실제 이용 앱도 나눠 보겠습니다.
정식 공개됐는데, 어디에서 쓸 수 있나요?
Google 공지 기준으로 Gemini 4 Argon은 Gemini 앱과 Google 검색의 AI Mode에서 Google AI Pro 또는 Ultra 가입자에게 제공됩니다. Google Antigravity는 AI Ultra 구독 경로가 안내됐고, 개발자·기업은 Gemini API와 Google의 기업용 플랫폼을 이용할 수 있습니다. API 모델 ID는 gemini-4-argon이며 무료 API 티어가 아닌 유료 티어 대상입니다. 계정별 노출 시점은 단계적 제공에 따라 다를 수 있습니다. Google 출시 공지 · Gemini API 가격표
Argon의 눈에 띄는 사양은 입력·사고(thinking)·출력이 함께 나눠 쓰는 1,048,576토큰 통합 컨텍스트입니다. 기본 동기식 응답은 최대 65,536토큰이고, 더 긴 추론·출력이 필요하면 Google이 안내하는 long decode 방식으로 최대 100만 토큰에서 입력분을 뺀 범위까지 확장할 수 있습니다. 사고 수준은 low·medium·high로 조절하며 기본값은 medium입니다. 장문의 자료나 다단계 작업에 유리한 구조지만, 컨텍스트가 길다는 사실 자체가 답변 정확성을 보장하지는 않습니다. Gemini 4 Argon 개발자 안내
- 비용을 줄이고 싶다면 출력 상한을 지나치게 낮추기보다 먼저
thinking_level을 낮춰 대표 작업으로 비교하는 편을 Google이 권장합니다. - 명시적 context caching은 지원하지 않고 4,096토큰 이상 프롬프트에는 implicit caching이 기본 적용될 수 있습니다. 출시 기간 캐시 적중 입력 단가는 100만 토큰당 $0.10입니다.
temperature·top_p·top_k같은 샘플링 파라미터는 Argon에서 무시됩니다.- 출력 가격에는 thinking token도 포함됩니다. 긴 추론을 쓰는 작업은 표면적인 답변 길이만 보고 비용을 계산하면 실제 사용량과 차이가 날 수 있습니다.
Claude Fable과 최신 GPT-6 계열, 무엇이 다른가요?
Claude에서는 Fable 5.1과 더 최근 공개된 Opus 5.5를 함께 볼 만합니다. Anthropic은 Fable 5.1을 야심 찬 장시간 코딩·지식 업무에 맞춘 가장 역량 높은 일반 제공 모델로 소개하고, Claude 앱·API에서 제공한다고 밝혔습니다. 반면 9월 공개된 Opus 5.5는 에이전트형 코딩, 컴퓨터 사용, 지식 업무를 겨냥하며, Fable보다 낮은 토큰 단가로 선택할 수 있습니다. 일상적인 버그 수정이나 빠른 반복 작업에는 9월 28일 공개된 Sonnet 5.5도 선택지입니다. 모델별 가격은 아래 표에 같은 단위로 정리했습니다. Claude Fable 5.1 제품 안내 · Claude Opus 5.5 발표 · Claude Sonnet 5.5 안내
GPT-6와 Codex는 서로 다른 종류의 이름입니다. 10월 7일 ChatGPT의 Chat 탭으로 확대된 GPT-6는 대화 중 시각 자료와 상호작용 UI를 만드는 Intelligent UI를 포함합니다. OpenAI 발표 기준으로 Plus·Pro·Business·Enterprise의 GPT-6 Chat은 Sol이, Free·Go의 GPT-6 Chat은 Luna가 기반입니다. 코딩용 Codex는 모델 자체가 아니라 코드 저장소·앱 작업을 수행하는 작업공간/에이전트입니다. 특히 OpenAI는 10월 7일 GPT-6 Chat 배포가 Work와 Codex의 기반 모델을 함께 바꾸는 업데이트는 아니라고 명시했습니다. Codex·Work에서 선택 가능한 GPT-6.1 Sol·Astra 등은 별도의 모델 제공 범위와 플랜·워크스페이스 설정을 확인해야 합니다. 따라서 ChatGPT의 대화 모델과 Codex의 작업 기능을 한 제품처럼 묶어 가격·성능을 비교하지 않는 편이 정확합니다. OpenAI GPT-6 발표 · OpenAI 모델 선택 안내
코딩 평가에서는 누가 앞섰을까요?
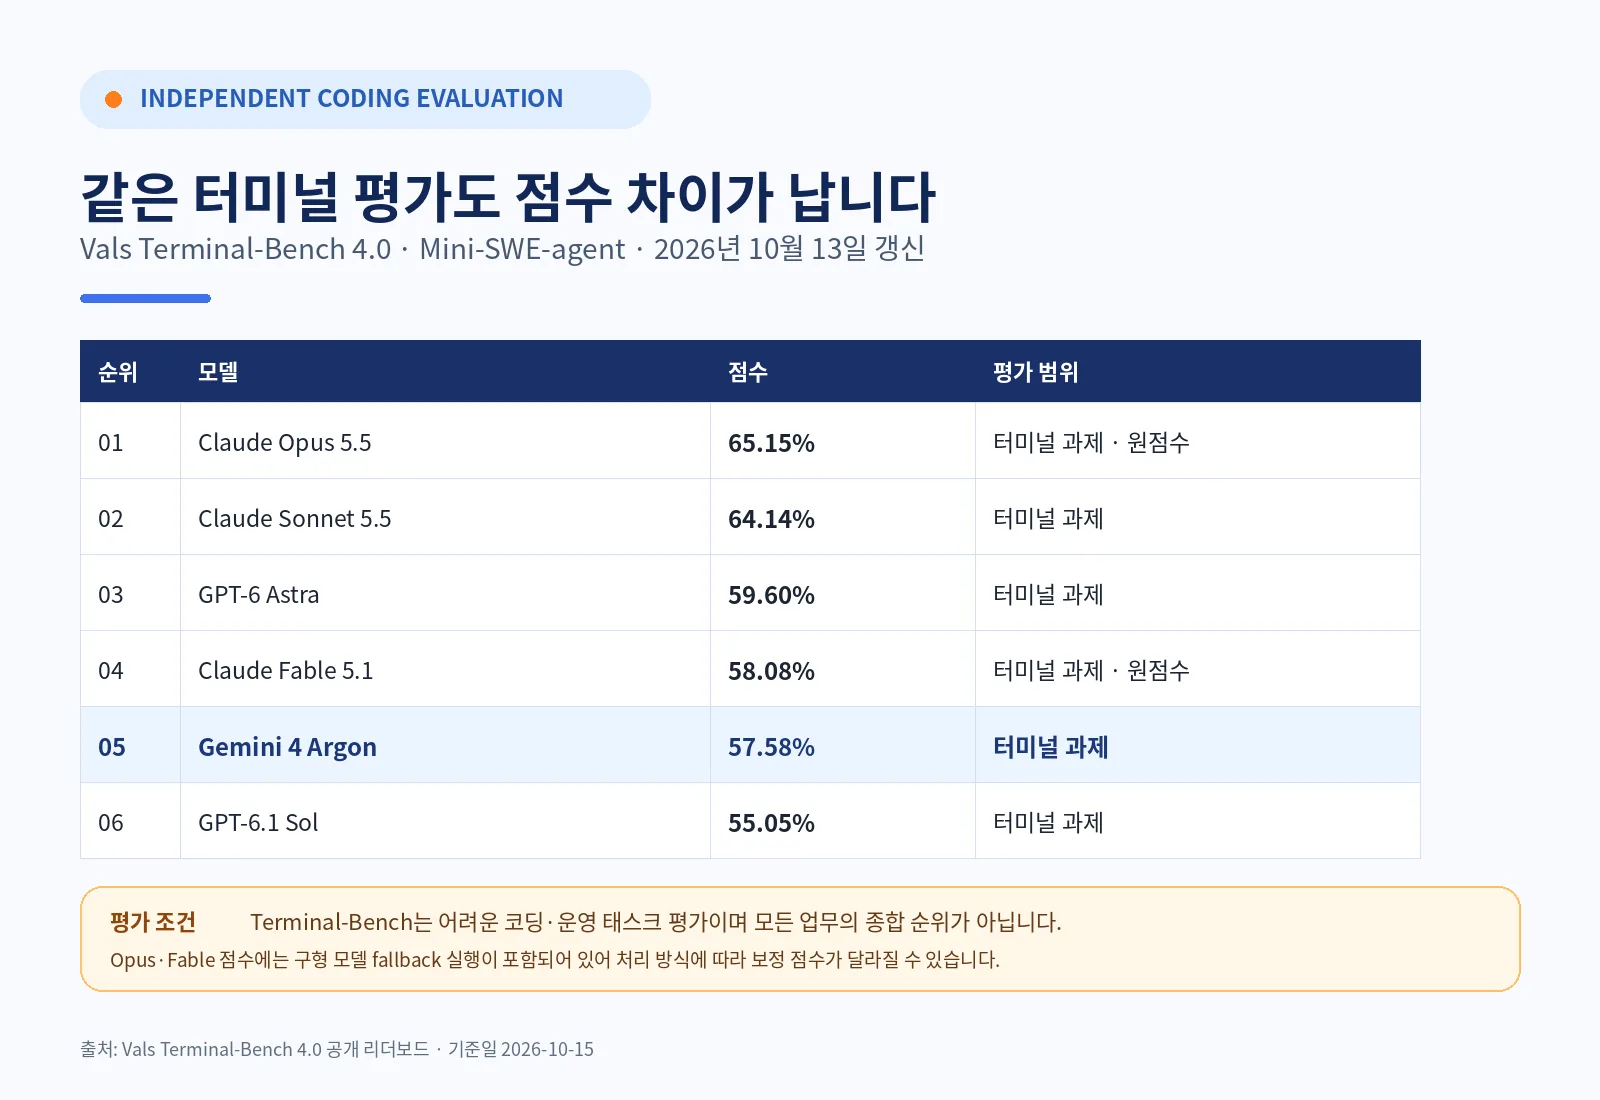
공개된 독립 평가 하나를 같은 조건에 맞춰 보면 차이가 구체적으로 보입니다. Vals가 2026년 10월 13일 갱신한 Terminal-Bench 4.0의 Mini-SWE-agent 결과에서 Claude Opus 5.5는 65.15%, GPT-6 Astra는 59.60%, Claude Fable 5.1은 58.08%, Gemini 4 Argon은 57.58%, GPT-6.1 Sol은 55.05%를 기록했습니다. 이 평가는 터미널에서 풀어야 하는 어려운 코딩·운영 태스크 결과로, 글쓰기나 검색·일상 대화까지 포함한 종합 순위는 아닙니다. Vals Terminal-Bench 4.0 결과와 방법론
| 같은 하네스 기준 모델 | Terminal-Bench 4.0 | 읽을 때 참고할 점 |
|---|---|---|
| Claude Opus 5.5 | 65.15% | 최고 원점수. 구형 모델 대체 응답 포함 |
| Claude Sonnet 5.5 | 64.14% | 일상 코딩의 비용·속도 대안 |
| GPT-6 Astra | 59.60% | GPT-6 계열 중 어려운 작업용 |
| Claude Fable 5.1 | 58.08% | 최상위 장시간 작업용 모델 |
| Gemini 4 Argon | 57.58% | 출시 직후 상위권 결과 |
| GPT-6.1 Sol | 55.05% | 코딩·전문 업무용, Astra보다 낮은 API 단가 |
점수 표에는 한 가지 운영상 조건이 있습니다. Vals는 Opus 5.5의 198회 시도 가운데 22회가 이전 Opus 모델로 대체됐다고 표시하며, 대체 실행을 실패로 보는 계산에서는 Opus 점수가 58.08%로 내려갑니다. Fable 5.1도 22회 대체 실행이 포함돼, 이를 실패로 보면 50.00%입니다. 결과를 통째로 부정할 이유는 없지만, 원점수만 보고 어느 한 모델이 모든 업무에서 우세하다고 판단하기는 어렵습니다.
종합 지표도 시험 구성에 따라 다른 그림을 줍니다. Artificial Analysis의 Intelligence Index에서 Argon(High)과 Fable(Max)은 각각 53점, GPT-6 Astra(Max)와 Fable(Max)도 각각 53점으로 나타납니다. 단, Argon은 High, Claude·Astra는 Max 설정이 포함된 서로 다른 비교 페이지라 완전히 같은 추론 강도로 겨룬 결과가 아닙니다. 점수 하나보다 내 작업과 비슷한 시험, 도구 사용, 실제 토큰 비용을 함께 보는 편이 낫습니다. Argon·Fable 비교 · Astra·Fable 비교
API 요금은 Argon이 언제까지 저렴할까요?
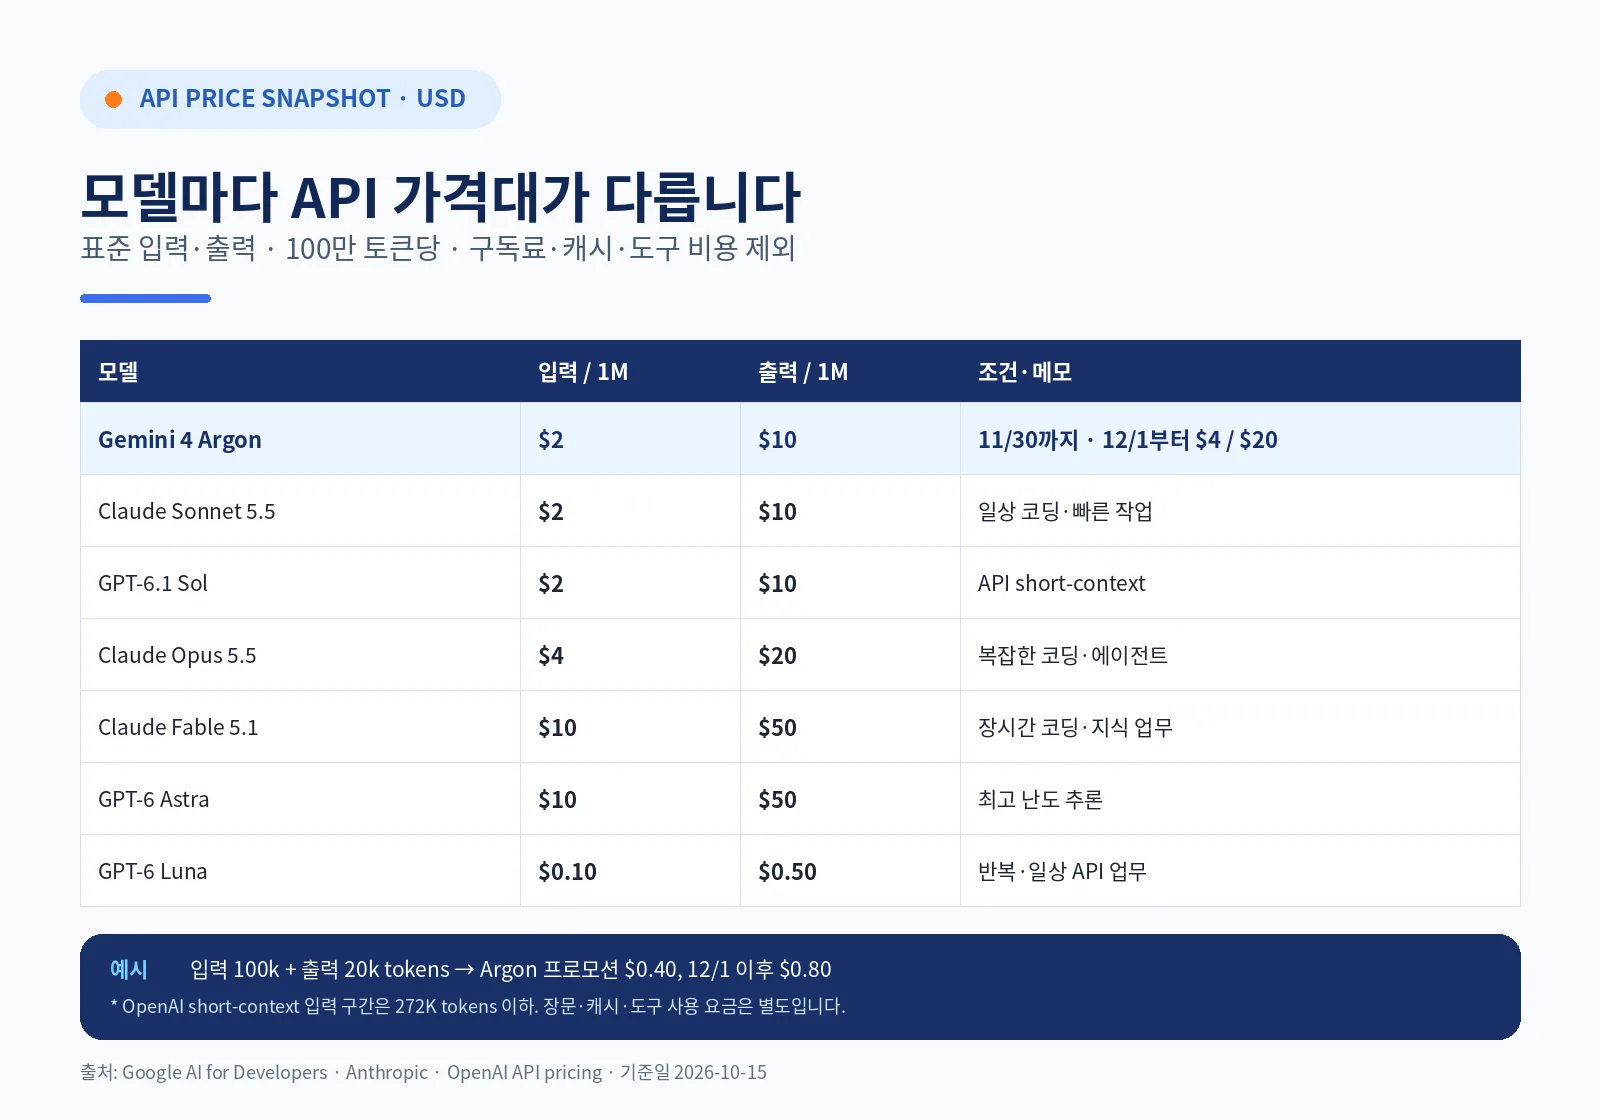
아래는 API의 표준 입력·출력 가격을 토큰 100만 개 단위로 맞춘 비교입니다. 앱·구독 플랜 요금이나 Codex 사용량 한도와는 다른 기준이며, OpenAI 모델 가격은 입력 27만 2천 토큰 이하의 short-context 구간입니다. 캐시 할인과 도구 호출 비용은 제외했습니다. Google 가격표 · OpenAI API 가격표
| 모델 | 입력 / 1M | 출력 / 1M | 적용·용도 |
|---|---|---|---|
| Gemini 4 Argon | $2 | $10 | 11월 30일까지 프로모션; 12월 1일부터 $4 / $20 |
| Claude Fable 5.1 | $10 | $50 | 장시간 코딩·지식 업무 |
| Claude Opus 5.5 | $4 | $20 | 복잡한 코딩·컴퓨터 사용·지식 업무 |
| Claude Sonnet 5.5 | $2 | $10 | 일상 코딩·빠른 반복 |
| GPT-6 Astra | $10 | $50 | 가장 어려운 추론·작업 |
| GPT-6.1 Sol | $2 | $10 | 복잡한 코딩·리서치; Codex/Work 모델 |
| GPT-6 Luna | $0.10 | $0.50 | 반복·일상 API 작업; ChatGPT Free·Go 경로와 구분 |
가령 입력 10만 토큰과 출력 2만 토큰을 쓰면 Argon 토큰 요금은 프로모션 기간 약 $0.40, 12월 1일 이후 약 $0.80입니다. 같은 사용량이면 Opus 5.5는 약 $0.80, GPT-6.1 Sol은 약 $0.40, Fable 5.1과 GPT-6 Astra는 각각 약 $2.00, GPT-6 Luna는 약 $0.02입니다. Argon의 implicit cache가 실제로 적중하면 입력 단가는 더 낮아질 수 있습니다. 실제 청구액은 캐시, 검색·코딩 도구, 재시도, 사고 토큰을 포함한 토큰 소비량에 따라 달라질 수 있고, Codex나 Claude 구독으로 이용할 때는 별도 플랜 규칙이 적용됩니다.
초기 해외·국내 반응은 어떤가요?
👍 이런 반응이 많았습니다
- “가격은 확실히 메리트” — 프로모션 API 단가가 비교적 공격적이라는 반응
- “1M 컨텍스트는 눈길 간다” — 큰 자료 묶음을 한 번에 넣기 좋다는 기대
- “코딩은 생각보다 괜찮네” — 일부 실사용 코딩에서 기대 이상이라는 평가
👎 이런 반응도 함께 나왔습니다
- “완전 압도는 아님” — 기존 최상위 모델을 밀어낼 정도냐에는 신중론
- “체감은 좀 갈린다” — 사람마다 확 좋아졌다고 느끼는 정도가 다름
- “안정감·생태계는 더 봐야” — 롤아웃·도구·워크플로 적응은 추가 확인 필요
출시 직후 공개 커뮤니티 글 몇 건에서는 성능 순위보다 실제 이용 가능 시점, 구독과 API 비용, 한국어 글쓰기 감각에 대한 기대가 먼저 오갔습니다. 루리웹의 한 초기 게시물에는 한국어 창작·문장 스타일에 대한 기대와 함께 계정에 모델이 아직 보이지 않는다는 질문이 섞였고, FMKorea 토론에서는 11월 말 이후 단가와 실제 사용 성능을 지켜봐야 한다는 의견이 나왔습니다. Hacker News 토론도 응답의 문장력에 대한 호평과 rollout·구독 접근의 혼선, 다른 모델 대비 비용을 둘러싼 의견이 함께 보였습니다. 이 몇 개의 토론은 출시 당일의 반응 신호일 뿐, 이용자 전체의 여론이나 통제된 성능 시험은 아닙니다. 루리웹 초기 반응 · FMKorea 토론 · Hacker News 토론
내 작업에 맞는 모델은 어떻게 고르면 될까요?
- 큰 문서 묶음·Google 생태계·프로모션 가격: Argon을 먼저 시험해 볼 만합니다. 1M 통합 컨텍스트와 현재 API 프로모션이 장점이지만, 12월 1일 이후 가격도 예산에 넣어야 합니다.
- 오래 이어지는 어려운 코딩·지식 작업: Claude Fable 5.1과 Opus 5.5를 비교해 보세요. Fable은 더 높은 토큰 단가, Opus는 더 낮은 단가의 선택지입니다. 일상적인 수정이나 빠른 반복에는 Sonnet 5.5도 후보입니다.
- ChatGPT UI 중심: GPT-6의 인터랙티브 답변을 활용하고, 저장소 단위 코딩 작업은 Codex에서 계정에 열린 모델을 확인하세요. 가장 깊은 추론이 필요한 Astra와 비용·반복 실행을 고려한 Sol은 역할과 가격이 다릅니다.
참고 자료
- Google, Gemini 4 Argon 출시 안내 (2026-10-13)
- Google AI Studio, Gemini API 가격표
- Google AI Studio, Gemini 4 Argon Developer Guide
- Google DeepMind, Gemini 4 Argon Model Card
- Anthropic, Claude Fable 5.1
- Anthropic, Claude Opus 5.5
- Anthropic, Claude Sonnet 5.5 (2026-09-28)
- OpenAI, GPT-6 and Intelligent UI for everyone (2026-10-07)
- OpenAI, A model guide for the GPT-6 family
- OpenAI API pricing
- OpenAI Codex models and availability
- OpenAI, ChatGPT Work and Codex
- Vals, Terminal-Bench 4.0 (2026-10-13 update)
- Artificial Analysis, Gemini 4 Argon vs Claude Fable 5.1
- Artificial Analysis, GPT-6 Astra vs Claude Fable 5.1
이용안내 · 저작권 · 오류신고
힐링편의점은 생활정보, 웹도구, 계산기와 미니게임 등 일상에 도움이 되는 정보 및 편의 콘텐츠를 제공합니다. 게시물의 내용과 웹도구의 계산 결과는 참고용으로 이용해 주세요.
건강, 법률, 세무, 재정, 정부정책 등 중요한 판단이 필요한 정보는 관련 기관의 공식 자료나 해당 분야 전문가를 통해 다시 확인하시기 바랍니다. 미니게임과 테스트 결과는 오락 및 일반적인 두뇌 활동을 위한 것으로, 개인의 능력이나 건강 상태를 측정하거나 진단하는 자료가 아닙니다.
본 사이트가 직접 제작하고 권리를 보유한 콘텐츠, 디자인, 문구, 이미지와 웹도구 소스코드의 무단 복제, 재배포 및 상업적 이용을 금합니다. 내용을 인용하거나 공유할 경우 출처와 원문 링크를 함께 표시해 주세요.
외부 자료나 제3자 콘텐츠가 포함된 경우에는 해당 출처와 권리자의 이용 조건이 우선 적용됩니다.
© 2026 Healing Mart · 힐링편의점. All rights reserved.
웹도구나 미니게임이 정상적으로 작동하지 않거나 게시물에서 잘못된 정보를 발견하셨다면 아래 오류 신고 페이지로 알려주세요. 게임 또는 도구 이름, 사용 기기, 브라우저와 오류 내용을 함께 남겨주시면 문제를 확인하는 데 도움이 됩니다.
신고 내용에는 비밀번호, 주민등록번호, 전화번호 등 불필요한 개인정보나 민감한 정보를 작성하지 마세요.
